CVAE 与 ACT 整体架构
从 AE 到 CVAE:生成模型基础
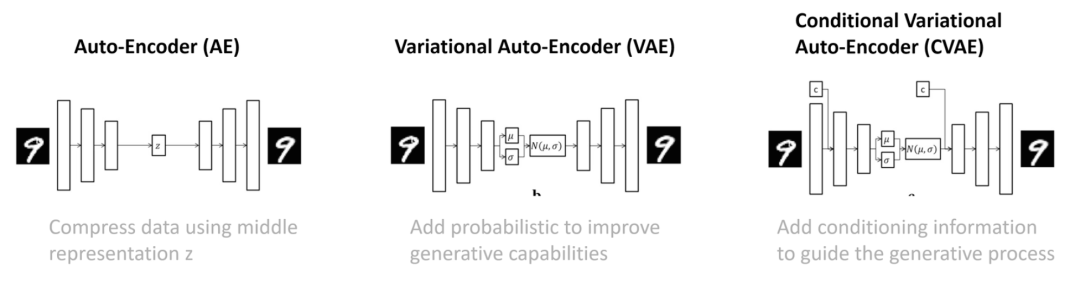
| 模型 | 核心思想 |
|---|---|
| Auto-Encoder (AE) | 通过编码器-解码器结构,用中间隐变量 z 压缩数据,学习紧凑表示 |
| Variational Auto-Encoder (VAE) | 在隐空间引入概率分布 N(μ, σ),增强生成能力,能采样出多样化的输出 |
| Conditional VAE (CVAE) | 加入条件信息 c 来指导生成过程。ACT 使用 CVAE 建模在给定观测条件下的动作序列分布 |
ACT 架构总览
先记住一句话:
ACT = 1 个条件 VAE(生成风格 z)+ 1 个 Transformer 编码器-解码器(融合信息、生成动作)
输入:4 张相机照片 + 关节状态 → 输出:未来 k 步动作
第一步:5 个组件的"职责地图"
| 组件 | 名称 | 职责 |
|---|---|---|
| ① | 视觉编码器 ResNet18 | 把 4 张照片压缩成摘要 |
| ② | 线性投影层 Linear | 关节状态转标准格式(14D → 512D) |
| ③ | 风格编码器 Style Encoder | 训练时提炼风格 z(μ, σ → z) |
| ④ | Transformer Encoder | 融合所有信息成"情况简报" |
| ⑤ | Transformer Decoder | 生成 k 步动作块 |
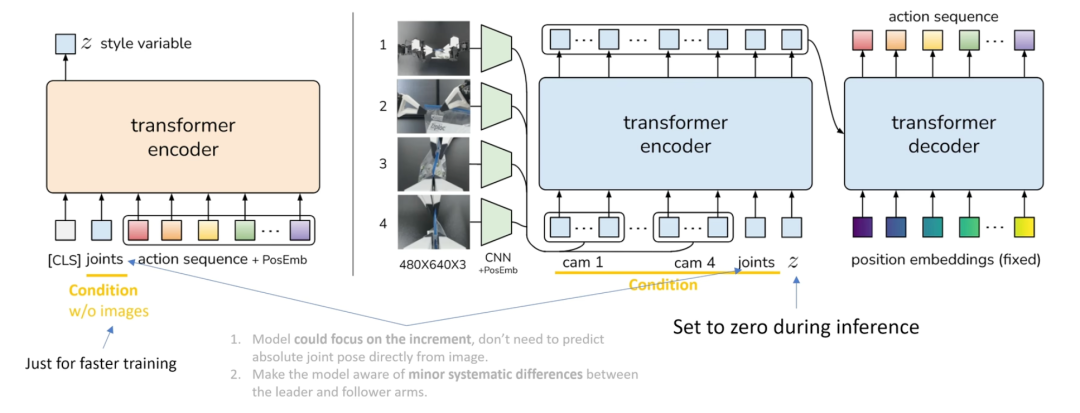
先别急着抠细节,跟着图走一遍,把图上的英文标注顺带认一认:
- 🔴 左侧粉红框是 ③ 风格编码器:训练时它偷看
future actions(未来的真实动作,也就是"标准答案"),连同current joints(当前关节状态)一起送进 Transformer,最后从[CLS](序列开头的"汇总位")读出μ, σ,再采样出风格向量z。 - 🔵 右侧大框是 ①④⑤:
4 RGB images(4 张彩色照片)先过CNN / ResNet18变成特征向量,再和current joints、z一起,靠positional encoding(位置编码)排好先后顺序,送进Transformer Encoder融合成"情况简报",再由Transformer Decoder一次输出action sequence(k×14 个数字的动作块)。
第二步:逐个组件拆解
① 视觉编码器 ResNet18 —— 负责"看图"
| 输入 | 输出 |
|---|---|
| 4 张 480×640 彩色照片(RGB) | 4 个特征向量(每张照片一行"摘要") |
- 怎么做:18 层卷积网络逐层提取信息——先看边缘、再看形状、最后看懂"锅在哪、菜什么状态"。对应图中
4 RGB images与CNN / ResNet18。 - 类比:像阅卷老师快速扫 4 张照片,每张写一行摘要:"照片 1 锅冒烟、照片 2 手在盘子上方"……后续大脑只读摘要,不再看原图。
② 线性投影层 Linear Projection —— 负责"统一格式"
| 输入 | 输出 |
|---|---|
| 14 个数字(7 关节 × 角度/速度) | 1 个 512 维向量 |
- 怎么做:一个简单的矩阵乘法"格式转换器",把 14 维向量映射成 512 维,同时可学习如何更好地表达关节状态。对应图中
current joints——机器人此刻手脚在哪、怎么摆的,是决策的实时依据。 - 类比:把不同单位的材料(照片摘要、关节读数、风格 z)全部翻译成同一种语言、同一尺寸的文档,才能放进同一台机器处理。
③ 风格编码器 Style Encoder —— 负责"提炼风格",只在训练时工作
| 输入 | 输出 |
|---|---|
[CLS] + 当前关节 + 未来真实动作序列(训练时偷看"标准答案") | 风格向量 z(由 μ、σ 采样得到)——一句话概括"这段示范怎么做" |
- 怎么做:序列开头放着一个特殊标记
[CLS],它是整条序列的**"汇总位"**——像班级的收件箱:其他所有 token(照片、关节、动作)都会把自己的信息汇总给它。Transformer 处理完整条序列后,只需读[CLS]位置就能拿到全局信息,从中读出 μ、σ,再用重参数化技巧采样出 z。μ, σ是风格分布的均值与标准差——μ 是"风格中心"、σ 是"波动范围"。 - 类比:考试前偷偷看一遍答案,总结一句"这人是快速颠勺的/慢慢摆放的"。考试时(测试)答案被收走,风格编码器整个关闭,z 直接置 0。
④ Transformer Encoder —— 负责"融合信息"
| 输入 | 输出 |
|---|---|
| 4 个照片特征 + 1 个关节向量 + 1 个 z(共 6 个 token,都带位置编码) | 一份"当前情况简报"(上下文向量),给解码器随时查阅 |
- 怎么做:自注意力(self-attention)让 6 个 token 两两交换信息:照片 1 说"锅冒烟"、关节说"手在锅上方"、z 说"快速颠勺",最终融合成统一结论。每个 token 进入前都会先加一份
positional encoding——相当于给每个人发一个"我是第几位"的号码牌,Transformer 本身不分先后,靠这个才知道"第 1 张照片、第 2 张照片、关节、z"的顺序。 - 类比:6 个人开会讨论"现在是什么情况",达成共识后形成一份会议纪要。
⑤ Transformer Decoder —— 负责"生成动作",一次想好 k 步
| 输入 | 输出 |
|---|---|
| 情况简报 + 固定位置编码(1~k 号位),提前摆好 k 个输出槽位 | 未来 k 步动作(k × 14 个数字),这就是"动作块" |
- 怎么做:7 层交叉注意力(cross-attention)模块,每想一步动作都回头查阅简报,确认这一步该动哪个关节、动多少。解码器开头摆着固定的
positional encoding(1~k 号位),所以能一次性想好 k 步。 - 类比:k 张答题卡已按 1~k 号摆好,解码器对着会议纪要逐张填答案,一次填完 k 张——这就是 Chunking。
第三步:把组件串起来 —— 数据怎么流动
训练时(有标准答案):
📷 4 张照片 → ① ResNet18 看懂 → + 关节 → ④ Encoder 融合 → ⑤ Decoder 生成 k 步 → 和标准答案对比,算误差旁边:③ 风格编码器偷看标准答案 → 提炼 z,一起喂给 Encoder。
测试时(没有标准答案,独立上岗):
📷 4 张照片 → ① ResNet18 看懂 → + 关节 → ④ Encoder 融合 → ⑤ Decoder 生成 k 步 → Follower 执行动作③ 风格编码器被关闭,z = 0。
两个容易被忽略的巧妙设计
设计一:预测"增量"而不是"绝对角度"
模型不直接回答"我的手臂现在应该在哪个绝对位置",而是回答**"我的手臂下一步要往哪边挪多少"**。就像开车导航只告诉你"下一个路口右转",而不是"你的绝对经纬度是多少"。这样模型不需要从照片里精确推算绝对位置,学起来容易得多。
设计二:自动补偿 Leader 和 Follower 的细微差异
示教臂(Leader)和执行臂(Follower)虽然是同一型号,但关节之间总有一点点微小的制造误差。模型通过训练学会了**"看 Follower 当前姿势 → 预测下一步该加多少"**,把这一点点系统误差自动修正掉。